Dataset
I dati di un template: query SQL e funzioni in sola lettura, bind variable, campi, relazioni e limiti.
Un dataset sono i dati che un template stampa: una query in sola lettura su una sorgente dati, con bind variable valorizzate dai parametri del template. Un template può avere più dataset — la testata di un DDT, le sue righe, i dati della ditta — e li modifichi nel pannello Dataset del Designer.
Che cos'è un dataset
codicetestoobbligatorio- Lettere, cifre e _, senza iniziare con una cifra; unico nel template. Le espressioni lo usano: TESTATA.NUMERO.
sorgente daticodice- La sorgente dati che il dataset legge; vuoto = la sorgente dati predefinita del workspace.
cardinalità1 / N record- 1 record: la prima riga si usa ovunque. N record: righe scorse da tabelle e data region.
origineSQL · Funzione · Condivisa- Da dove arrivano le righe (vedi sotto).
timeoutsecondi- Timeout della query, 30 per impostazione predefinita.
campielenco- Le colonne del risultato, rilevate eseguendo la query.
abilitatosì/no- Un dataset disabilitato non viene né controllato né letto.
Si leggono solo i dataset abilitati che il layout usa davvero, una volta per documento. I dataset della stessa sorgente dati si leggono uno dopo l'altro in un'unica transazione in sola lettura, quindi vedono un'istantanea coerente dei dati.
SQL, funzioni e query condivise
- SQL: una sola
SELECT(oWITH) nel dialetto della sorgente dati, con bind variable:NOME. Un;finale è ammesso. - Funzione: una routine del database che restituisce righe, con gli argomenti collegati a bind variable. Su PostgreSQL, una funzione che restituisce un insieme di righe (
SELECT * FROM schema.funzione(:ARG1, …)). Su Oracle, una funzione pipelined o che restituisce una collection, una funzione che restituisce unSYS_REFCURSOR, una procedura con un soloOUT SYS_REFCURSOR, oppure una funzione che restituisce un valore o un oggetto (vedi Oracle). - Condivisa: una query della libreria Query condivise del workspace, riusata tra più template (per esempio i dati del vettore). Quando il template viene pubblicato, l'SQL della query condivisa viene copiato nella versione: le modifiche successive alla query condivisa non cambiano mai i documenti pubblicati.
SELECT d.NUMERO, d.DATA, c.RAGSOC, c.INDIRIZZO, c.CITTA FROM DDT_TESTATA d JOIN CLIENTI c ON c.CODICE = d.CLIENTE WHERE d.ID = :DOCUMENT_IDSELECT r.RIGA, r.ARTICOLO, a.DESCRIZIONE, r.QUANTITA, r.PREZZO FROM DDT_RIGHE r JOIN ARTICOLI a ON a.CODICE = r.ARTICOLO WHERE r.DDT_ID = :DOCUMENT_ID AND (:SOLO_DISPONIBILI = 0 OR a.GIACENZA > 0) ORDER BY r.RIGA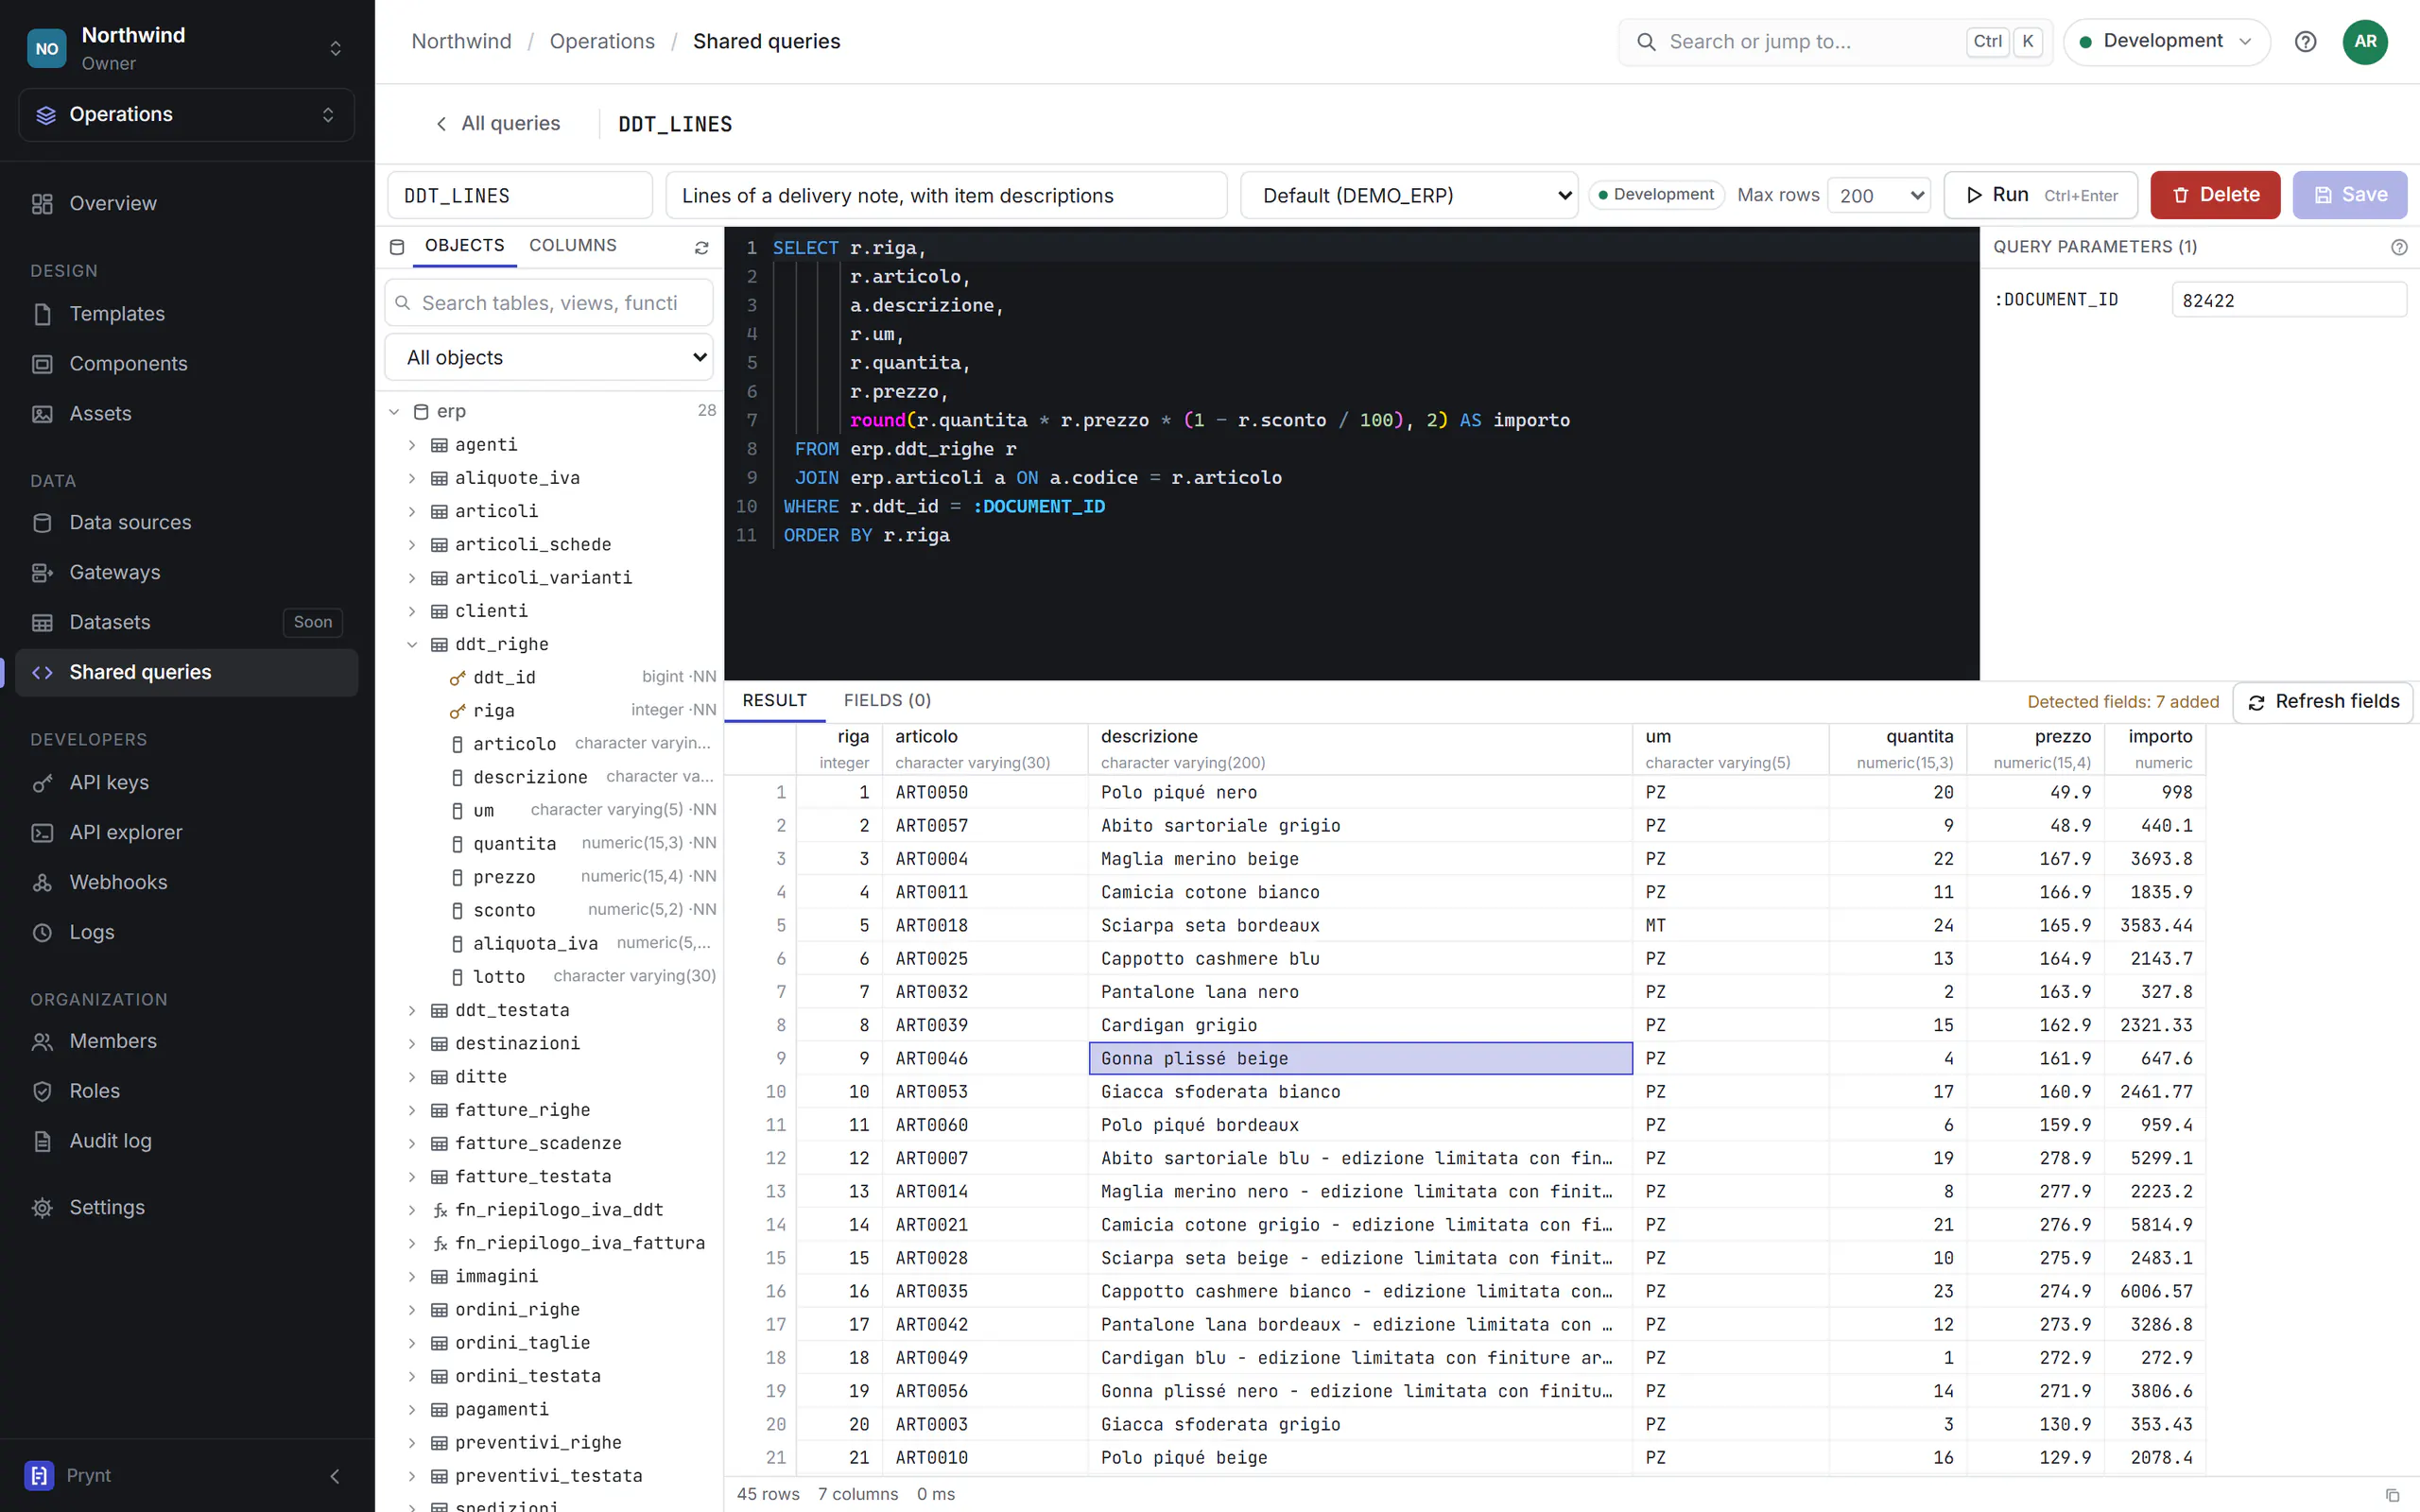
In sola lettura per costruzione
Prynt non scrive mai nei tuoi database. Ogni query è protetta due volte:
- Prima dell'esecuzione, un controllo per dialetto accetta una sola istruzione che inizia con
SELECT,WITH,VALUESoTABLE, e rifiutaINSERT,UPDATE,DELETE,MERGE,TRUNCATE,INTO,FOR UPDATEe istruzioni multiple, anche dentro una CTE. Su Oracle è rifiutato anche il PL/SQL dichiarato nella query (WITH FUNCTION). Il controllo avviene al salvataggio e alla pubblicazione (SQL_NOT_READ_ONLY), e di nuovo prima di ogni esecuzione, anche sul Gateway. - Durante l'esecuzione, la query gira in una transazione in sola lettura (
SET TRANSACTION READ ONLY) che viene sempre annullata. Una routine che prova a scrivere o a fare commit fallisce.
Usa comunque un utente del database in sola lettura
Bind variable e parametri
Ogni :NOME nell'SQL riceve un valore, sempre come bind variable tipizzata: i valori non vengono mai concatenati nel testo SQL, quindi non possono cambiare la query. Nell'ordine, un bind prende il valore da:
- un collegamento esplicito del dataset (sezione Parametri della query): un parametro del template, un valore di sistema o una costante;
- il parametro del template con lo stesso nome:
:DOCUMENT_IDlegge il parametroDOCUMENT_ID; - il valore di sistema con lo stesso nome:
DITTA(la ditta del contesto della richiesta),USER,LANGUAGE,DATE,NOW.
Un bind che non corrisponde a nulla è un errore al salvataggio (BIND_UNRESOLVED); Crea parametro aggiunge con un clic il parametro mancante. Un valore nullo viene passato come NULL tipizzato, quindi i filtri facoltativi come (:CLIENTE IS NULL OR c.CODICE = :CLIENTE) funzionano. Approfondisci in Parametri.
Campi e tipi
I campi sono le colonne del risultato. Esegui la query, poi Aggiorna campi li scrive nel dataset con il loro tipo: i nomi sono in maiuscolo (i duplicati diventano CODICE_2) e le espressioni li usano come DATASET.CAMPO. I campi sono quello che trascini sulla pagina, e quello che i controlli usano per segnalare i nomi sconosciuti.
stringtesto- Colonne di testo, anche CLOB e testi lunghi.
integernumero- Colonne intere (su Oracle NUMBER(p,0) fino a 18 cifre).
decimalnumero- Altre colonne numeriche, decimali esatti.
datedata- Date senza ora (date di PostgreSQL).
dateTimedata e ora- Timestamp; un DATE di Oracle è sempre data e ora.
booleansì/no- Colonne booleane.
binarybyte- BLOB, bytea, RAW: immagini da un campo.
Un campo usato dal layout ma assente dal risultato fa fallire la generazione, con l'elenco delle colonne disponibili.
Un record o molti
- 1 record (testata, cliente, ditta): si usa la prima riga, e i suoi campi si possono usare ovunque nel template.
- N record (righe, taglie, scadenze): le righe vengono scorse da una tabella o da una data region, che può anche filtrarle, ordinarle e raggrupparle. Un campo di un dataset a N record usato fuori dalla sua tabella o region stampa la prima riga, con un avviso.
Più dataset e relazioni
Per i documenti master–detail (ordini → righe → taglie) definisci una relazione nel pannello Relazioni: un nome, il dataset padre, il dataset figlio e una o più coppie di campi chiave che devono essere tutte uguali. Una tabella o data region annidata nella region del padre mostra allora solo le righe figlie del record padre corrente, e i totali come sum(TAGLIE.QTA) seguono la relazione. Le relazioni sono risolte in memoria dal motore: ogni dataset viene eseguito una volta, non una volta per ogni riga del padre.
Dataset su sorgenti dati diverse
I dataset di un template possono leggere sorgenti dati diverse. Ogni sorgente dati viene letta nella propria istantanea, quindi la coerenza vale solo tra dataset della stessa sorgente dati (il Designer lo segnala con DATA_SOURCE_MULTIPLE).
Provare un dataset
- Esegui (Ctrl+Invio) lancia la query nell'ambiente scelto in alto nell'applicazione, con i valori di prova dei parametri, e mostra le righe con i loro tipi, il tempo e un avviso quando si è fermata al numero massimo di righe (50, 200 come predefinito, 1.000 o 10.000).
- Gli errori del database sono segnati alla loro riga e colonna nell'editor SQL; su Oracle vedi il codice ORA-.
- L'Anteprima (F5) genera l'intero documento con gli stessi valori di prova: il PDF vero, dai dati veri.
Eseguire e modificare le query richiede il permesso sql.execute (developer, admin, owner); i designer vedono le query ma non possono eseguirle né modificarle.
Limiti e timeout
Righe per dataset200.000- In una generazione tramite API. Anteprime nel Designer: 50.000. Oltre il limite la generazione fallisce (non viene mai troncata in silenzio).
Dati per generazione256 MB- Tutti i dataset di un documento insieme.
Timeout della query30 s- Predefinito di un dataset; fino a 3.600 s nelle generazioni, 60 s nelle anteprime del Designer.
Prova del dataset10.000 righe- Righe massime di Esegui nell'editor dei dataset (200 come predefinito).
Gatewaylimiti locali- Un gateway può applicare limiti propri più severi (righe, byte, timeout).
Un dataset che fallisce o supera un limite fa fallire la generazione con DATASET_FAILED. Filtra nella query (WHERE) invece che nel layout: legge meno dati.
I dataset nell'API
POST /v1/datasets/{template}/{dataset}/execute restituisce in JSON le righe di un dataset di un template pubblicato, con i tuoi parametri: utile per mostrare nella tua applicazione i dati di un documento. L'SQL non viene mai esposto e l'API non accetta mai SQL. Vedi il riferimento API.